Podcast transkribieren auf Schweizerdeutsch, mit Sprechern und Zeitmarken
Mundart in sauberen Text zu bringen, geht heute in wenigen Minuten pro Folge. Entscheidend sind drei Dinge: eine gute Spracherkennung, eine Tonspur pro Person und ein fester Schritt zum Gegenlesen. So machen wir es bei «Laptop und Küchentisch» jede Woche.
Einen Podcast auf Schweizerdeutsch transkribierst du am besten in drei Schritten: Die Spracherkennung Whisper macht aus der fertigen Tonspur einen hochdeutschen Text mit Zeitmarken. Eine eigene Tonspur pro Mikrofon zeigt für jedes Wort, wer gerade spricht. Und ein Gegenlese-Schritt bringt Namen, Fachwörter und holprige Stellen in Ordnung.
Bei «Laptop und Küchentisch» dauert das für eine Folge von einer knappen Stunde wenige Minuten Rechenzeit. Bei Folge 67 kamen 559 Absätze und 2018 Untertitel heraus, mit Sprecher und Zeit, gegengelesen und mit Schweizer ss. Wie das im Einzelnen aussieht, zeigen wir hier.
Was eine Spracherkennung mit Mundart macht
Whisper versteht Schweizerdeutsch erstaunlich gut. Es schreibt aber nicht Mundart, sondern übersetzt ins Hochdeutsche. Das ist für ein Transkript meist genau richtig: Hochdeutsch lesen alle, und Titel, Shownotes und Untertitel entstehen später ohnehin auf Hochdeutsch.
Der Haken: Beim Übersetzen geht einiges verloren. Namen, Zahlen und Ortsnamen sind die häufigsten Fehlerquellen, kleine Wörter wie «halt» oder «jetzt» fallen gern weg. Ab und zu erfindet die Erkennung sogar einen Satz, der nie gesagt wurde. Ein paar echte Beispiele aus Folge 67:
| Die Erkennung hörte | Gegengelesen |
|---|---|
| Channing sieht so richtig zum Verknudeln aus. | Janine sieht so richtig zum Verknuddeln aus. |
| Wegen deinen Hempern. | Wegen deinen Hemden. |
| Welche zwei Becher? Häuterkers und | Welche zwei Becher? Hüttenkäse und |
| mit der 9. Pause | in der Znünipause |
Der Sinn ist fast immer erkennbar. Für ein Transkript, aus dem du Zitate für Reels und Posts ziehst, reicht das aber nicht. Darum liest bei uns jede Folge ein zweiter Durchgang gegen.
Schritt 1: Die richtige Tonspur wählen
Transkribiere die fertige, geschnittene Folge, nicht die Rohaufnahme. Nur so passen die Zeitmarken später zu Kapiteln und Untertiteln. Bei uns ist das die Tonspur nach Adobe Podcast und dem Schnitt.
Hast du zwei Fassungen, etwa eine für Spotify mit Intro-Song und eine für YouTube ohne, brauchst du die Zeiten zweimal. Der Song verschiebt bei uns alles um 26,5 Sekunden. Kapitel und Untertitel gibt es darum pro Fassung. Wie wir Titel und Kapitel daraus bauen, steht im Artikel Shownotes, Titel und Kapitel mit KI.
Schritt 2: Whisper lokal laufen lassen
Wir nutzen Whisper large-v3-turbo lokal auf einem Mac mini. Eine Stunde Audio braucht 3 bis 6 Minuten. Die Aufnahmen verlassen das Haus nicht, und es fallen keine Kosten pro Minute an.
Drei Einstellungen haben bei uns den Unterschied gemacht:
- Sprache fest auf Deutsch. Sonst rät Whisper bei Mundart manchmal falsch.
- Ein kurzer Startsatz mit Podcastname und Namen. Zum Beispiel: «Laptop und Küchentisch. Ein Podcast mit Oliver und Janine.» Damit schreibt Whisper eure Namen von Anfang an richtig.
- «condition_on_previous_text» aus. Mit der Standardeinstellung wiederholte Whisper bei uns Sätze oder liess 30 Sekunden leer. Seit die Option aus ist, laufen alle 67 Folgen sauber durch.
Lass dir Zeitmarken pro Wort ausgeben. Die brauchst du für die Sprecher und später für Reels, die genau am Satzende schneiden.
Schritt 3: Sprecher über die Mikrofone bestimmen
Das ist der grösste Hebel für ein gutes Transkript, und er beginnt bei der Aufnahme: ein Mikrofon pro Person, jedes auf einer eigenen Spur. Die Einzelspuren kommen nicht in den Ton der Folge. Sie verraten nur, wer gerade spricht.
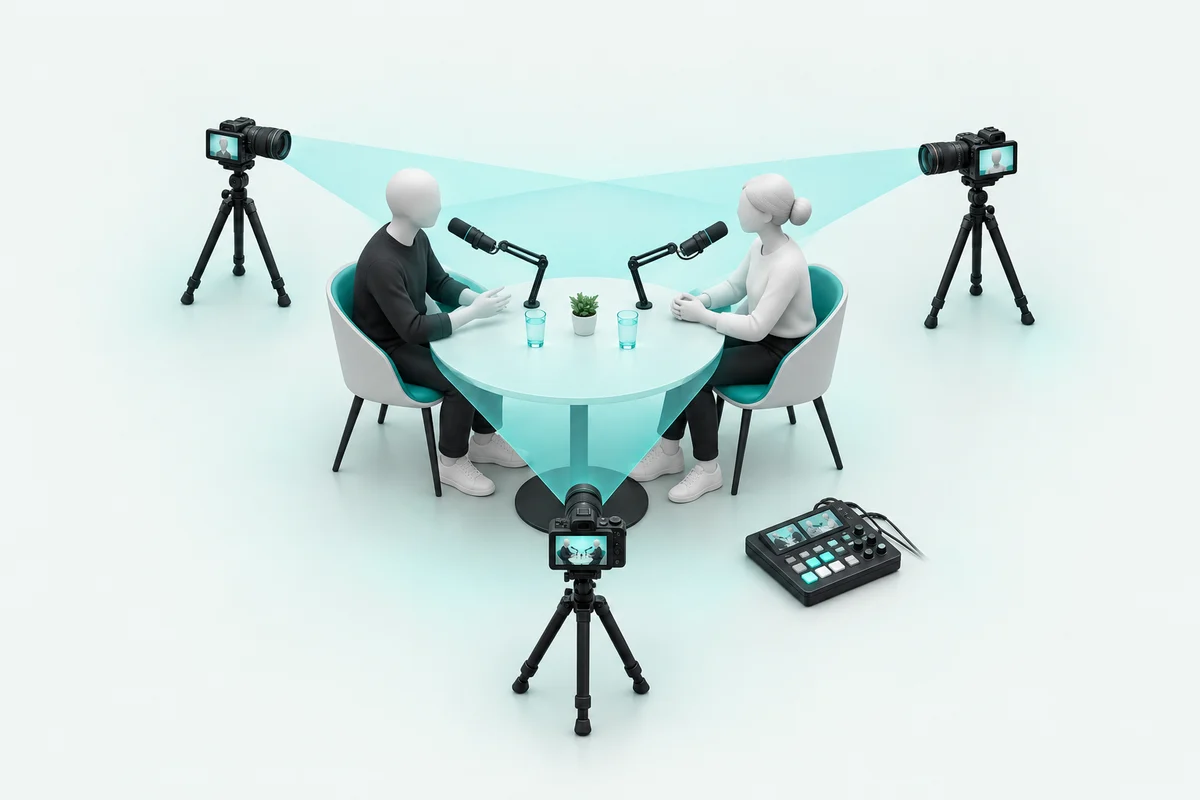
Für jedes Wort vergleichst du, welches Mikrofon in diesem Moment lauter war. Dieses Mikrofon gehört zur sprechenden Person. Das Übersprechen zwischen den Mikrofonen liegt bei uns rund 17 dB tiefer und stört nicht.
Ein einfacher Plausibilitätstest: Bei uns spricht Oliver 60 bis 75 % der Zeit. Bei Folge 67 waren es 64 %, Janine 36 %. Kippt das Verhältnis plötzlich, sind die Spuren vertauscht. Ein Blick auf die ersten fünf Absätze zeigt es sofort.
Ohne Einzelspuren geht es auch, nur ungenauer. Für unser Buchprojekt haben wir alle 67 Folgen transkribiert, auch die ersten sechs ohne Einzelspuren. Dort half eine Stimmerkennung, im Test stimmten 92 % der Wörter. Welche Aufnahme-Varianten es gibt, siehst du unter Formate.
Schritt 4: Gegenlesen, ohne zu kürzen
Jetzt wird aus dem Rohtext ein Transkript, das trägt. Die Regeln dafür sind einfach:
- Flüssiges Hochdeutsch, aber nichts kürzen. Füllwörter massvoll glätten, den Inhalt nie verändern.
- Eine Fixliste pflegen. Begriffe, die immer falsch erkannt werden, kommen auf eine Liste. Bei uns zum Beispiel der Name der Community: «Tischgspänli». Die Erkennung schrieb lange etwas ganz anderes.
- Wortfetzen an der richtigen Stelle. An Sprecherwechseln landen Wortanfänge oft in der falschen Zeile. Die gehören zur Person, die sie gesagt hat.
- Erfundenes löschen. Sätze, die nicht in der Aufnahme vorkommen, fliegen raus.
- Keine Regieanweisungen. Kein «(lacht)», kein «(Pause)».
- Schweizer ss. Immer «ss», nie das scharfe S. Ein kurzes Prüfskript am Schluss findet jedes übersehene Zeichen.
Wichtig ist die Liste der unsicheren Stellen. Bei Folge 67 sah sie so aus: Minute 32:43, «Trog» als Spülbecken gedeutet. Minute 33:54, «Häuterkers» als Hüttenkäse. Minute 35:09, «in der Znünipause». Du hörst nur diese paar Sekunden nach, statt die ganze Folge.
Welches Format das Transkript haben sollte
Wir legen pro Folge drei Dateien ab:
- Ein Textdokument mit Absätzen im Format «00:50:48 Oliver: Text». Daraus entstehen Titel, Shownotes, Kapitel und Karussells.
- Untertitel mit Sprecher als SRT, höchstens 32 Zeichen pro Untertitel. So bleiben sie auch auf dem Handy lesbar.
- Untertitel ohne Sprecher für YouTube, mit den Zeiten der YouTube-Fassung.
Ein Ausschnitt aus Folge 67, wie er auf der Website im echten Beispiel steht: «00:51:01 Janine: Danke, das war das perfekte Stichwort.» Aus dieser Stelle wurde später Reel 1 über die Männergrippe. Wie aus solchen Stellen Reels werden, zeigt der Artikel Reels aus einer Podcast-Folge.
Typische Fehler beim Transkribieren
- Die Rohaufnahme transkribieren. Dann stimmen die Zeiten nach dem Schnitt nicht mehr.
- Nur eine Mischspur aufnehmen. Das Transkript klappt, die Sprecher werden aber zur Handarbeit.
- Dem Rohtext blind vertrauen. «Hüttenkäse» als «Häuterkers» fällt auf. Ein falscher Name in einem Zitat fällt erst auf, wenn er online ist.
- Beim Gegenlesen kürzen. Ein Transkript soll wiedergeben, was gesagt wurde. Gekürzt wird später, in Captions und Karussells.
- Die Fixliste vergessen. Jeder Begriff, den du einmal korrigierst, gehört auf die Liste. Sonst korrigierst du ihn jede Woche.
Fazit: Mundart ist kein Hindernis
Schweizerdeutsch zu transkribieren ist heute kein Problem mehr. Whisper liefert in wenigen Minuten einen hochdeutschen Text mit Zeitmarken. Eine Spur pro Mikrofon löst die Sprecherfrage fast von selbst. Und ein Gegenlese-Schritt mit Fixliste macht daraus ein Transkript, auf das du Reels, Titel und Shownotes bauen kannst. Bei uns bleibt für eine ganze Folge ein Nachhören von ein paar Stellen.
Wenn du diesen Ablauf nicht selbst zusammenbauen willst: Im Toolkit übernimmt Claude Transkript, Sprecher und Gegenlesen, und du hörst nur die unsicheren Stellen nach.
Häufige Fragen
Kann eine Spracherkennung Schweizerdeutsch schreiben?
Sie versteht Mundart gut, schreibt sie aber als Hochdeutsch. Die Bedeutung bleibt meist erhalten, Namen, Zahlen und Ortsnamen gehen dabei oft verloren. Darum gehört ein Gegenlese-Schritt fest dazu.
Wie erkennt das Transkript, wer spricht?
Am zuverlässigsten mit einer eigenen Tonspur pro Mikrofon. Jedes Wort gehört dann der Person, deren Mikrofon gerade lauter war. Ohne Einzelspuren wird der Sprecher aus dem Zusammenhang bestimmt, das ist ungenauer.
Wie lange dauert das Transkript einer Folge?
Bei uns rechnet Whisper large-v3-turbo lokal auf einem Mac mini 3 bis 6 Minuten pro Stunde Audio. Dazu kommen ein paar Minuten, um die unsicheren Stellen kurz nachzuhören.